모든 PDF를 검색 가능하게 만드세요. 어떤 이미지에서든 텍스트를 추출하세요. 100% 오프라인으로 작동합니다.

80개 이상의 언어에서 98% 이상의 정확도를 자랑하는 기업용 OCR SDK입니다. 몇 시간 내에 통합하고 원하는 방식으로 배포하세요.

  • 98% 이상의 OCR 정확도 |
  • 80개 이상의 언어 지원 |
  • 크로스 플랫폼 SDK |
  • 자체 호스팅 지원 |
  • GDPR 준수

왜 ComPDF OCR인가요?

하나의 OCR 엔진으로 모든 플랫폼 지원. 데이터 외부 유출 없음.

문제점 1

검색 불가능한 스캔 PDF

원본 레이아웃을 유지하면서 텍스트 레이어가 포함된 검색 가능한 PDF 생성
전체 문서 저장소에 대한 즉각적인 전문(full-text) 검색
문제점 2

비용이 많이 드는 수동 데이터 입력

OCR 및 AI 파싱을 통해 텍스트, 표, 키-값(key-value) 쌍을 추출하여 구조화된 JSON/CSV/Excel로 변환
수동 문서 처리 업무량 85% 절감
문제점 3

클라우드 OCR 사용 불가

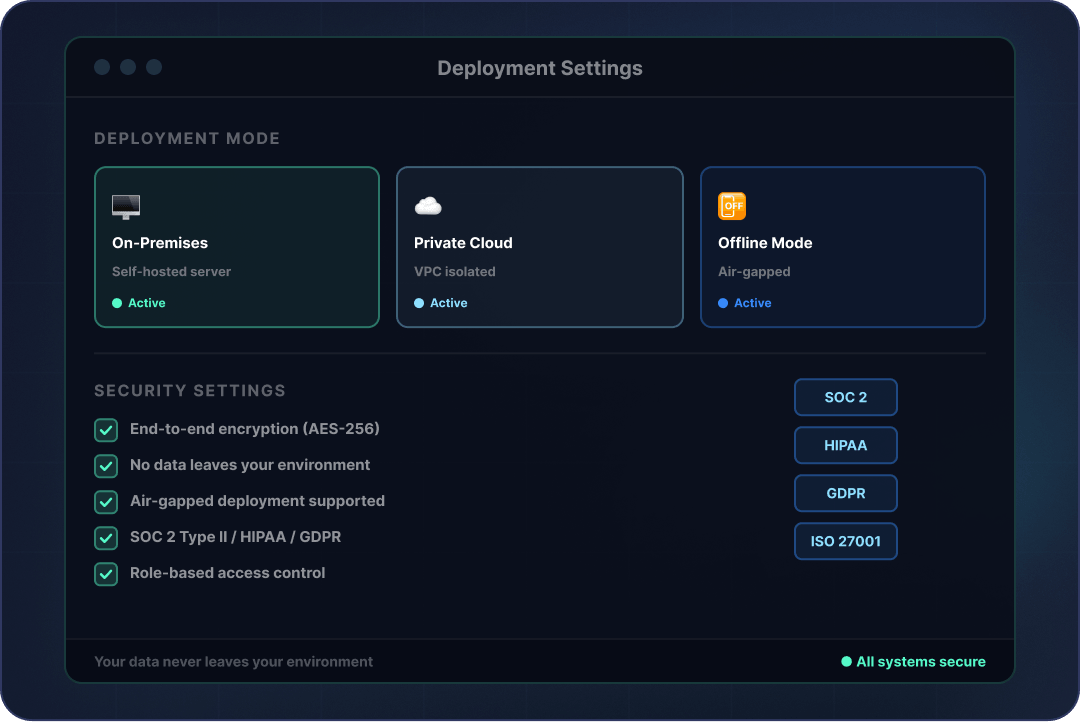
완전한 오프라인 OCR 엔진 — 모든 처리가 로컬 또는 귀사의 프라이빗 서버에서 수행됨
데이터 외부 유출 없음. 설계 단계부터 GDPR/HIPAA/ITAR 규정 준수
문제점 4

복잡한 레이아웃 인식 실패

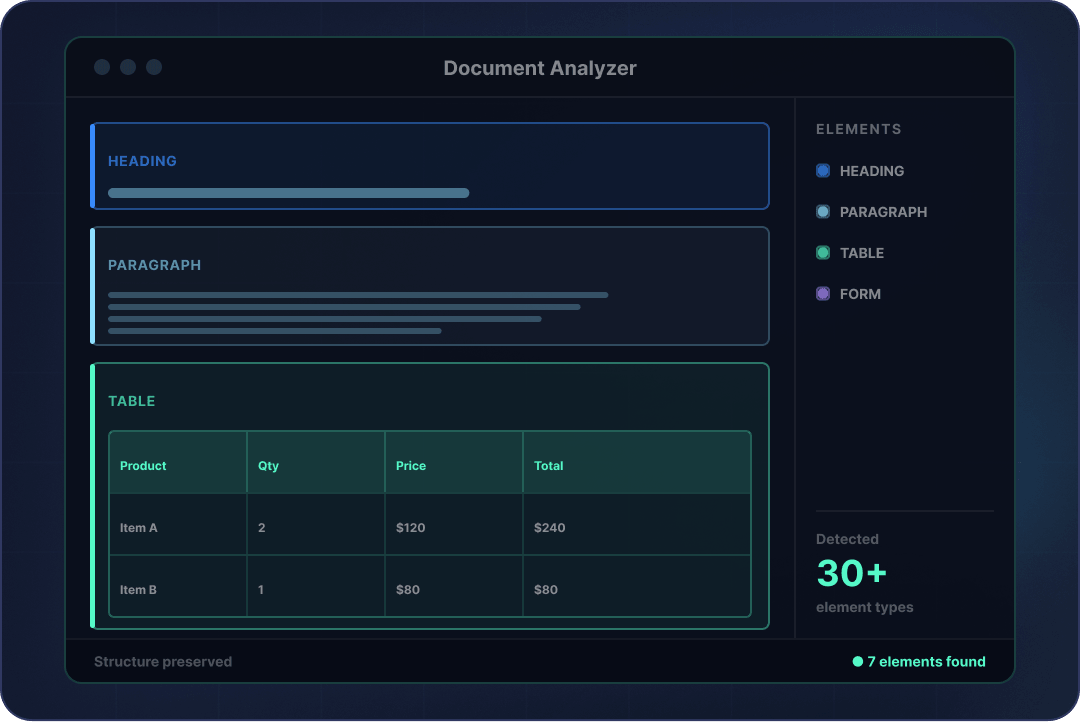
AI 기반 레이아웃 분석으로 30가지 이상의 요소 유형(다단, 표, 수기, 혼합 언어 등) 식별
실제 기업용 문서에서 98% 이상의 정확도
문제점 5

긴 통합 소요 시간

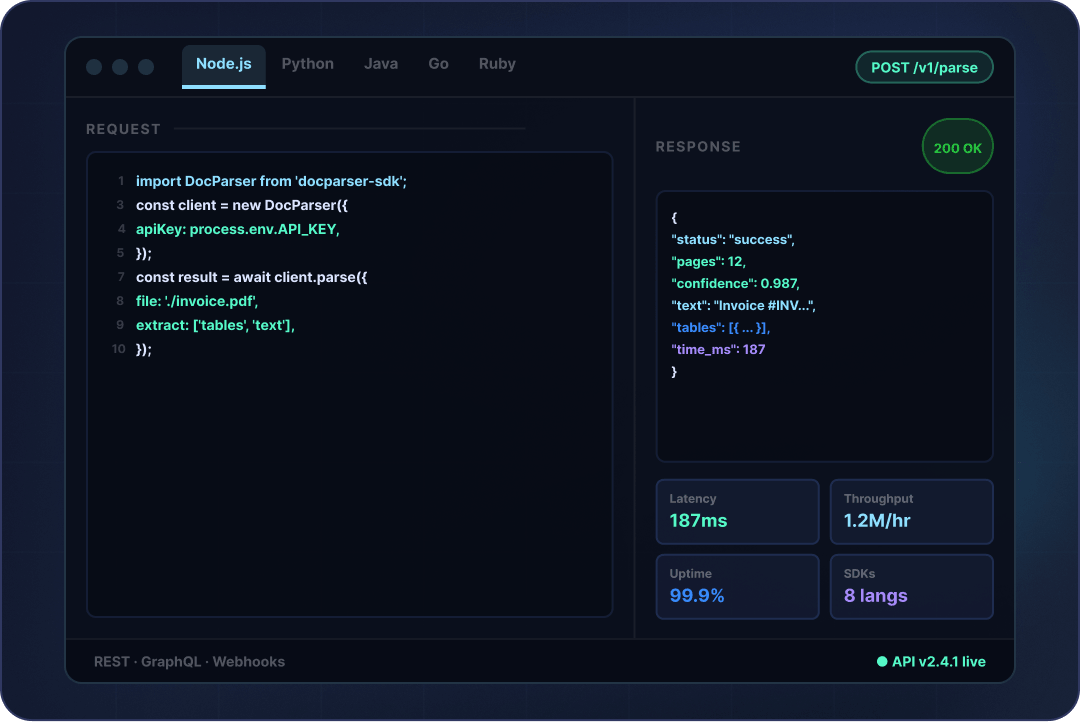
REST API를 통한 빠른 통합(수 시간 내 완료). 주요 플랫폼별 네이티브 SDK 제공.
오픈소스 OCR 기반 구축 대비 통합 소요 시간 60~80% 단축
문제점 6

멀티 플랫폼 환경의 파편화 문제

Windows, Linux, macOS, iOS, Android 및 Web을 아우르는 단일 OCR 엔진
일관된 결과물. 단일 공급업체. 단일 라이선스 모델.
엔터프라이즈급

엔터프라이즈급 OCR 성능

문자 인식 정확도(표준)
98%+
100페이지 문서
< 30 초
지원 언어
80+
식별 가능한 문서 요소 유형
30+
통합 소요 시간(SDK 및 API)
시간

AI 기반 문서 인텔리전스

98% 이상의 OCR 정확도

Accurately recognize scanned PDFs, images, and complex documents in 80+ languages.
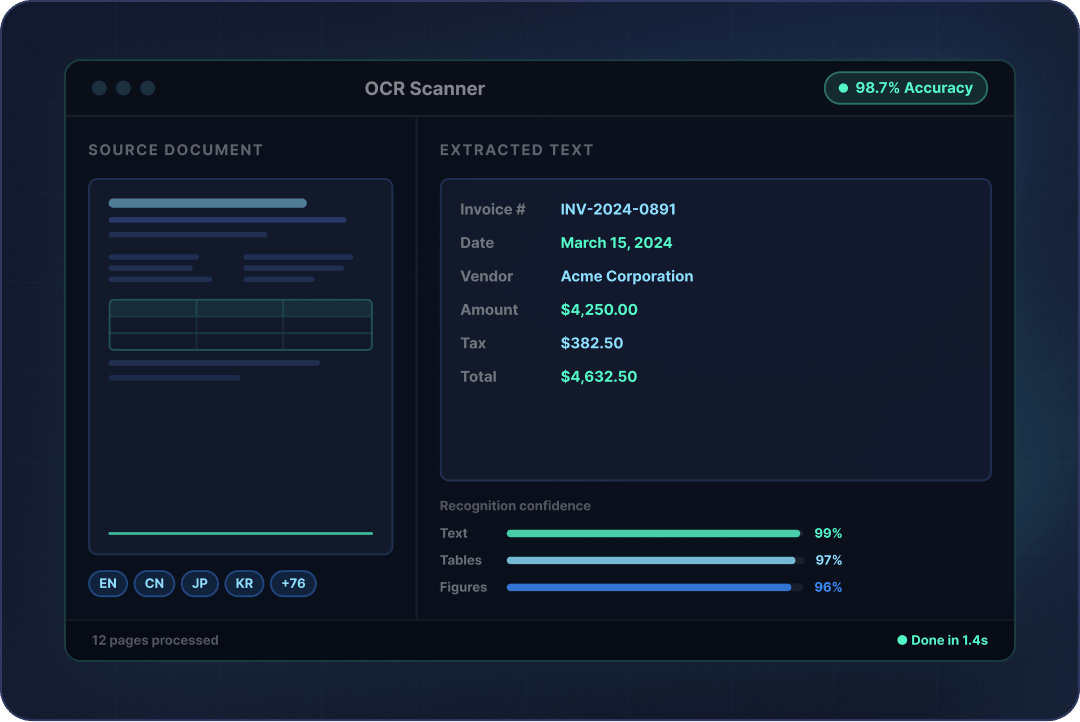
98% 이상의 OCR 정확도

레이아웃 유지 및 구조 추출

Detect tables, forms, headings, and 30+ elements while maintaining document structure.
레이아웃 유지 및 구조 추출

어디서나 배포 및 데이터 프라이버시 보호

Run on-premises, offline, or in private clouds with full data control.
어디서나 배포 및 데이터 프라이버시 보호

빠른 통합 및 간편한 확장

SDKs and REST APIs enable rapid deployment and high-volume document processing.
빠른 통합 및 간편한 확장
전체 워크플로

ComPDF OCR PDF가 문서를 변환하는 방식

  1. 스캔된 PDF / 이미지

  2. AI 레이아웃 분석

  3. OCR 인식

  4. 텍스트 추출

  5. 구조화된 출력

  6. 비즈니스 시스템

사용 사례

모든 산업을 위해 설계

Financial

금융 서비스

청구서/영수증 자동 처리, KYC 디지털화, 명세서 대조, 규제 보고용 문서 파싱. 처리 시간 80% 단축. 전사(transcription) 오류 99% 감소. 완전한 감사 추적(audit trail) 제공.

자세히 보기
Healthcare

의료

환자 서식 디지털화, 검사 결과 보고서 구조화, 진료비 청구 자동화, 임상 데이터 추출. 설계 단계부터 HIPAA 규정 준수. 환자 등록 및 절차 처리 속도 50% 향상. 청구 거부 사례 감소.

자세히 보기
Legal

법률

e디스커버리 처리, 계약서 분석, 법률 조사 자료 디지털화, 실사 자동화. 비밀유지 특권 보장. 조사 시간 60% 단축. 소송 즉시 활용 가능한 결과물 생성.

자세히 보기
Government

정부

시민 기록 디지털화, 입법 절차 처리, 정보공개법(FOIA) 관련 검색, 역사적 기록물 보존. 데이터 주권 보장. 에어갭(망 분리) 환경 배포. OFD 형식 지원.

자세히 보기
Education

교육

입학 절차 자동화, 학술 기록물 디지털화, 시험 처리, 연구 논문 구조화. 기록물 접근성 향상. 다국어 지원. 비용 효율적인 교육용 라이선스.

자세히 보기
IDP

지능형 문서 처리(IDP)

OCR 및 AI 파이프라인 통합. RAG 지식 베이스 구축. AI 에이전트용 MCP 서버. RPA 플랫폼 커넥터. ERP/CRM 데이터 수집. 템플릿 기반 데이터 추출. IDP 구축 속도 60~80% 향상.

자세히 보기

자주 묻는 질문

네. 완전히 오프라인으로 작동합니다. 모든 처리는 사용자의 기기, 서버 또는 프라이빗 클라우드에서 수행됩니다. 인터넷 연결이 필요하지 않으며, 데이터가 외부 서비스로 전송되지 않습니다.

모든 문서를 검색 가능하게 만들 준비가 되셨나요?

애플리케이션에 엔터프라이즈급 OCR 기능을 추가하세요. 98% 이상의 정확도. 80개 이상의 언어 지원. 완전 오프라인 작동.