課題 1
検索できないスキャン済みPDF
- 解決策
- ビジネス効果
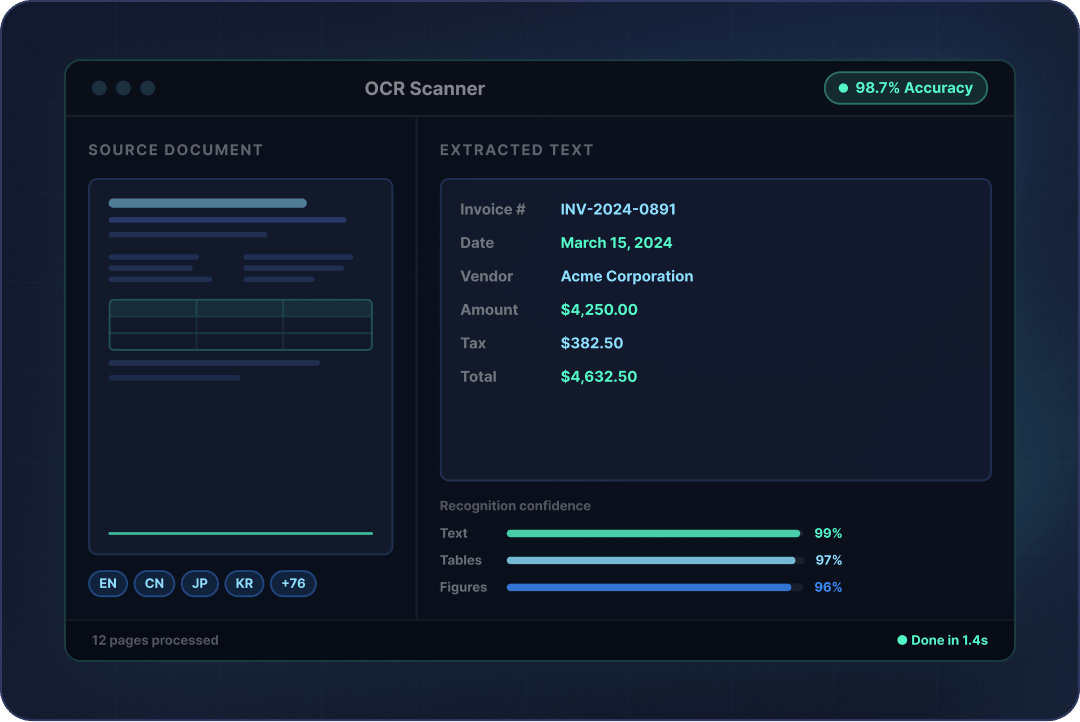
80以上の言語で98%以上の精度を誇るエンタープライズ向けOCR SDK。短時間で統合可能、運用形態も自由に選択できます。
単一のOCRエンジンであらゆるプラットフォームに対応。データ外部転送は一切なし。
Accurately recognize scanned PDFs, images, and complex documents in 80+ languages.
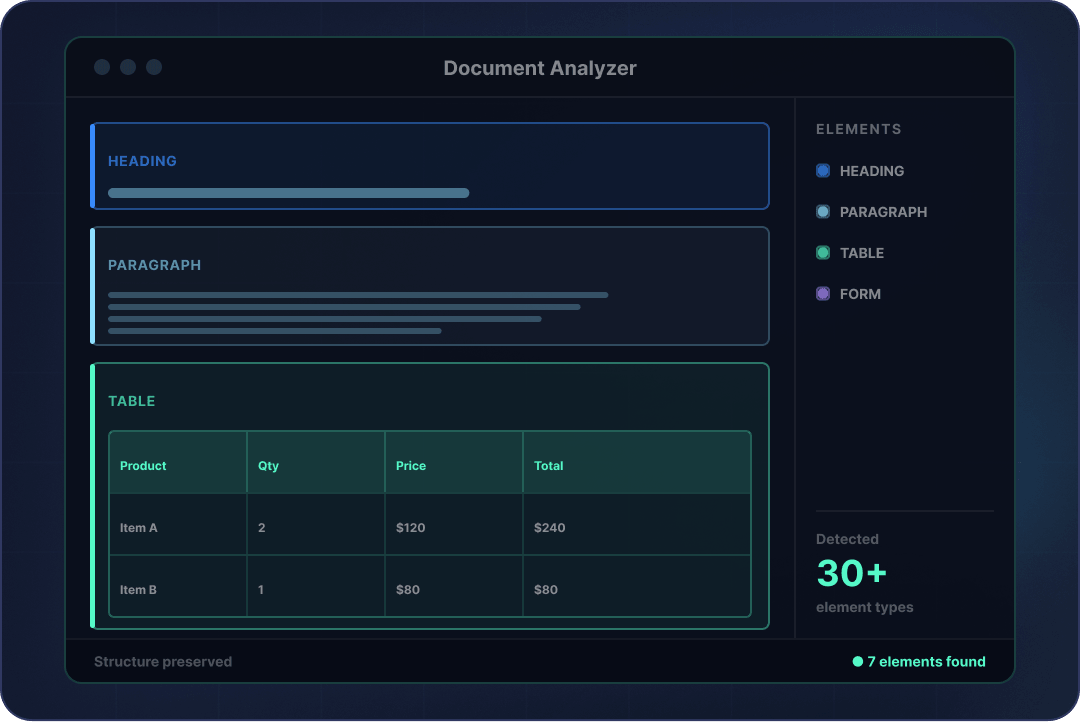
Detect tables, forms, headings, and 30+ elements while maintaining document structure.
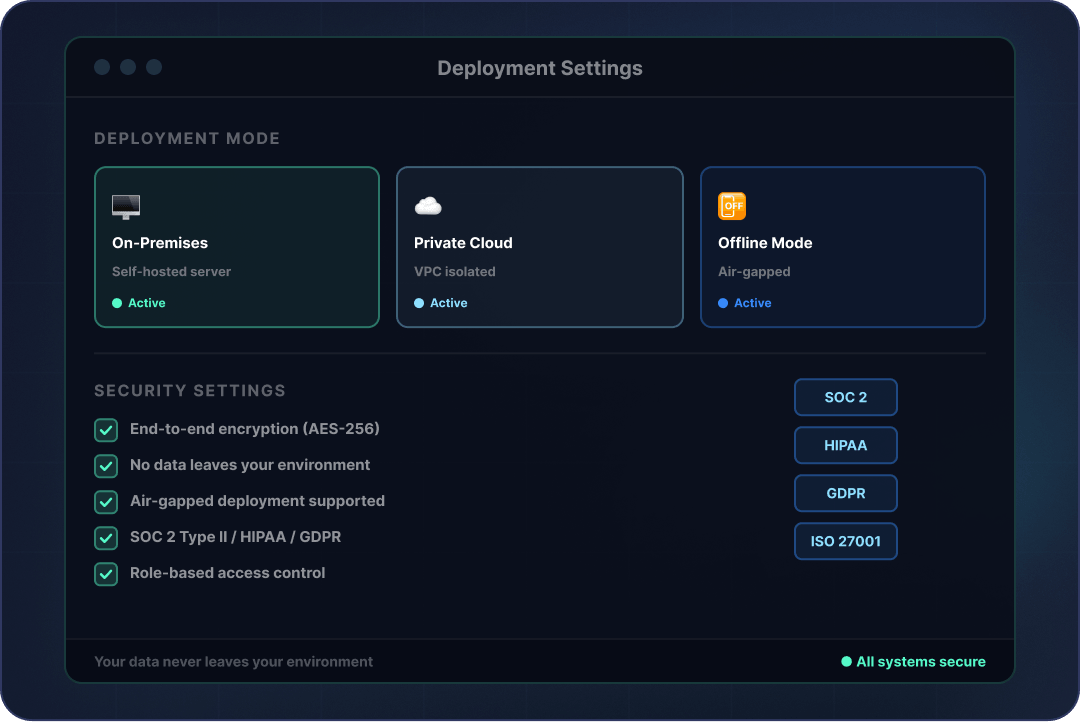
Run on-premises, offline, or in private clouds with full data control.
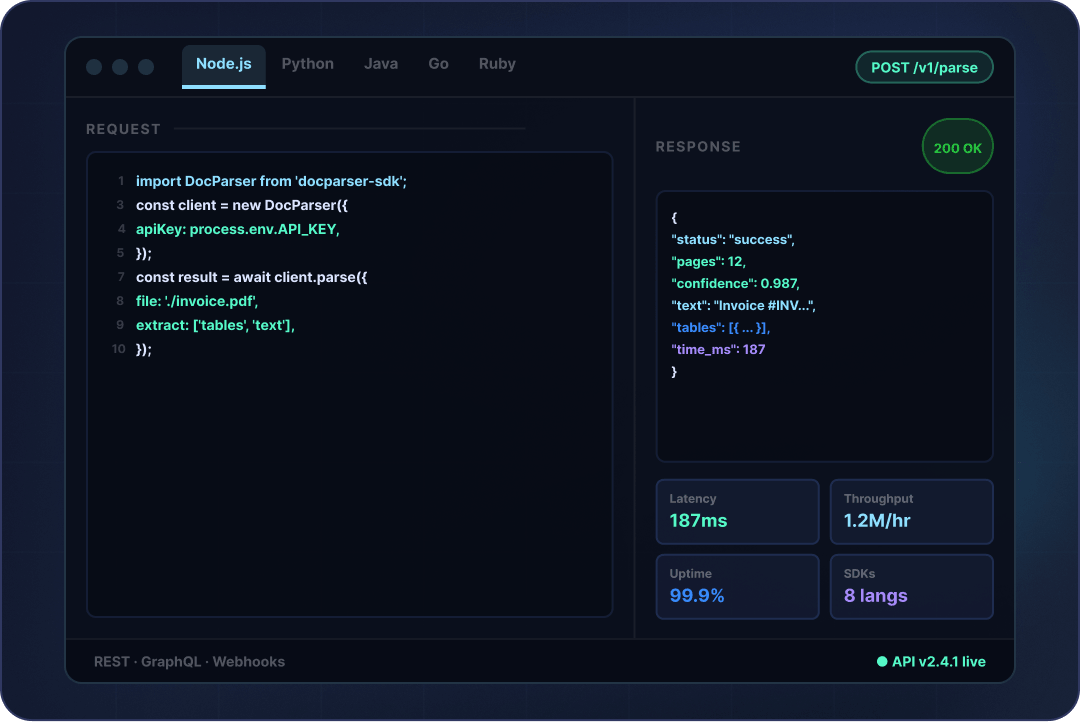
SDKs and REST APIs enable rapid deployment and high-volume document processing.
スキャン済みPDF / 画像

AIレイアウト解析
OCR認識
テキスト抽出
構造化データ出力
業務システム
はい。完全にオフラインで動作します。すべての処理はお使いのデバイス、サーバー、またはプライベートクラウド上で実行されます。インターネット接続は不要で、外部サービスにデータが送信されることはありません。