让每一份PDF都可搜索。让每一张图片的文字都能擷取。全部离线运行。

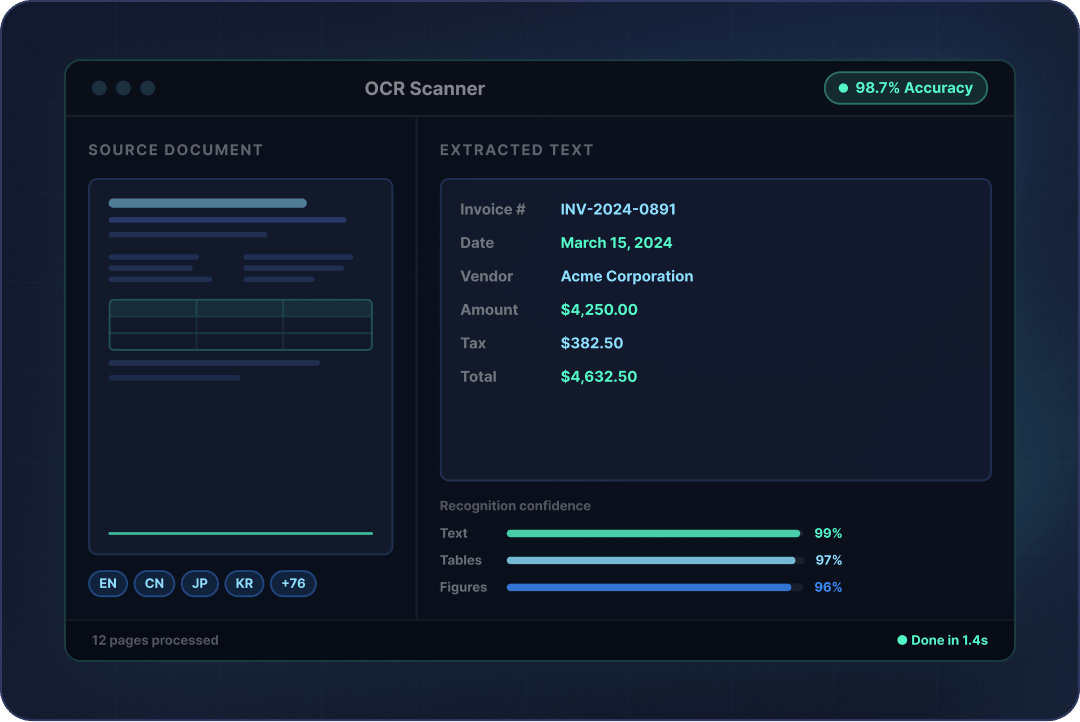
企业级OCR SDK,98%+识别准确率,支持80+语言。几小时集成,按需部署。

  • 98%+ OCR准确率 |
  • 80+语言 |
  • 跨平台SDK |
  • 支持私有化部署 |
  • 通过GDPR认证

为什么选择ComPDF OCR?

一套OCR引擎,覆盖所有平台,数据零出网。

痛点 1

扫描PDF不可搜索

生成带文字层的可搜索PDF,保留原始排版
文档库全量全文搜索,一键可达
痛点 2

手动录入成本高

OCR + AI智能解析,擷取文本、表格、键值对,输出结构化JSON/CSV/Excel
文档处理人工成本降低85%
痛点 3

云OCR不被合规允许

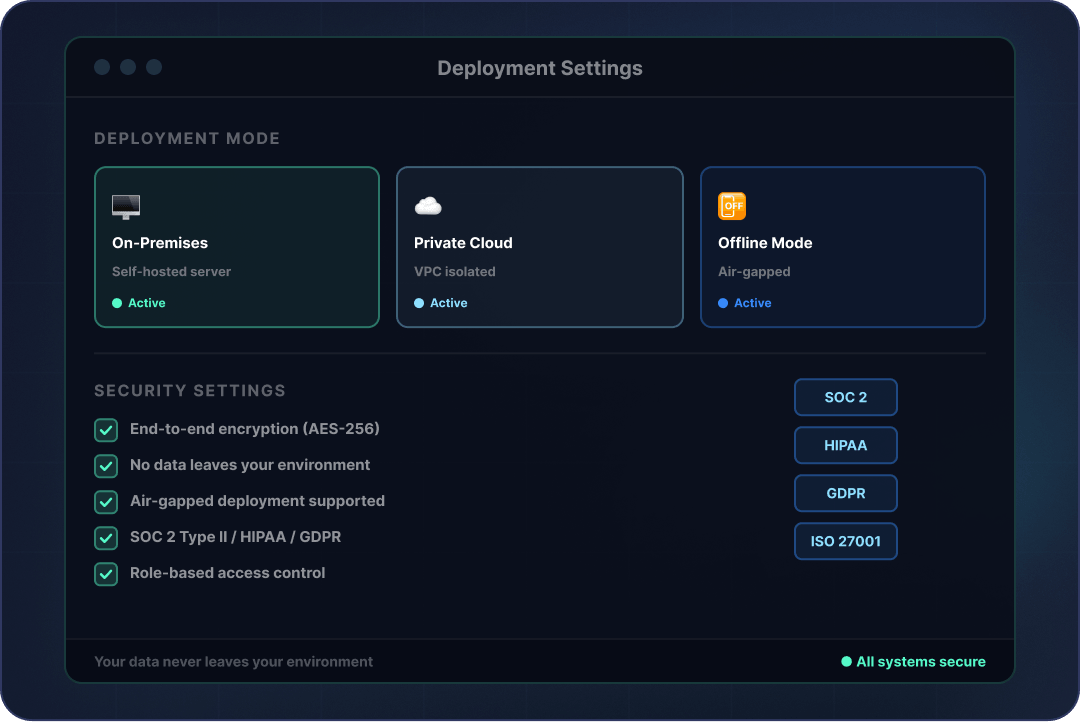
全离线OCR引擎——所有处理在本地或私有服务器完成
数据零出网,架构原生满足GDPR/HIPAA/ITAR合规
痛点 4

复杂版式识别差

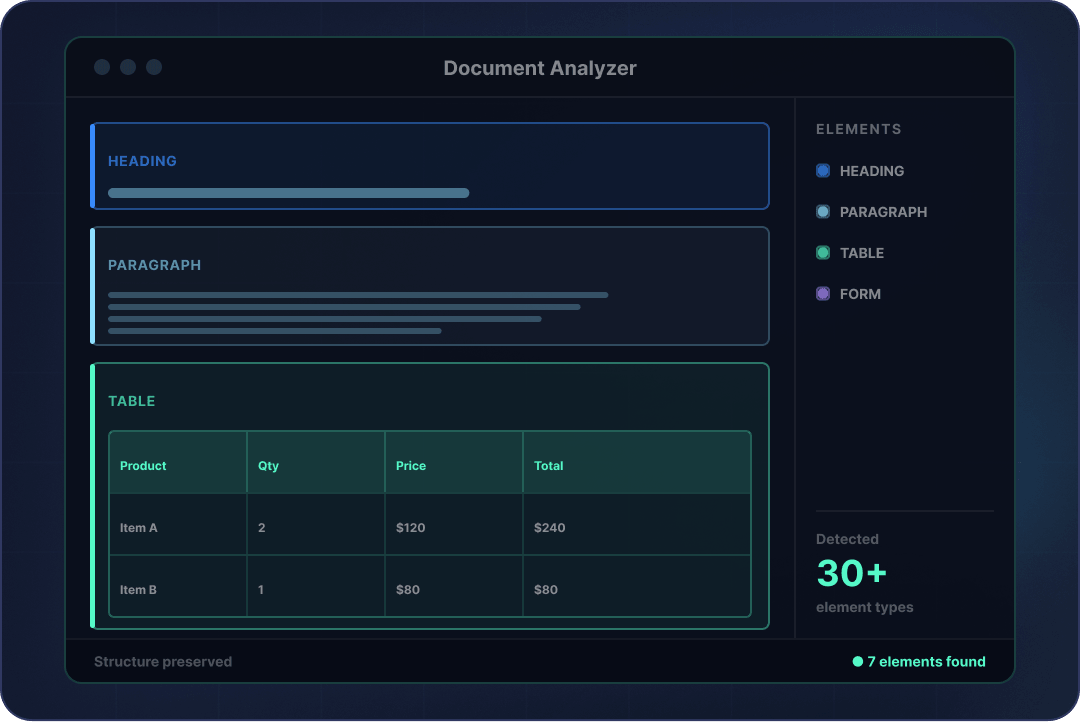
AI版式分析,识别30+元素类型——多栏、表格、手写字、混排语言
真实企业文档场景98%+准确率
痛点 5

集成周期长

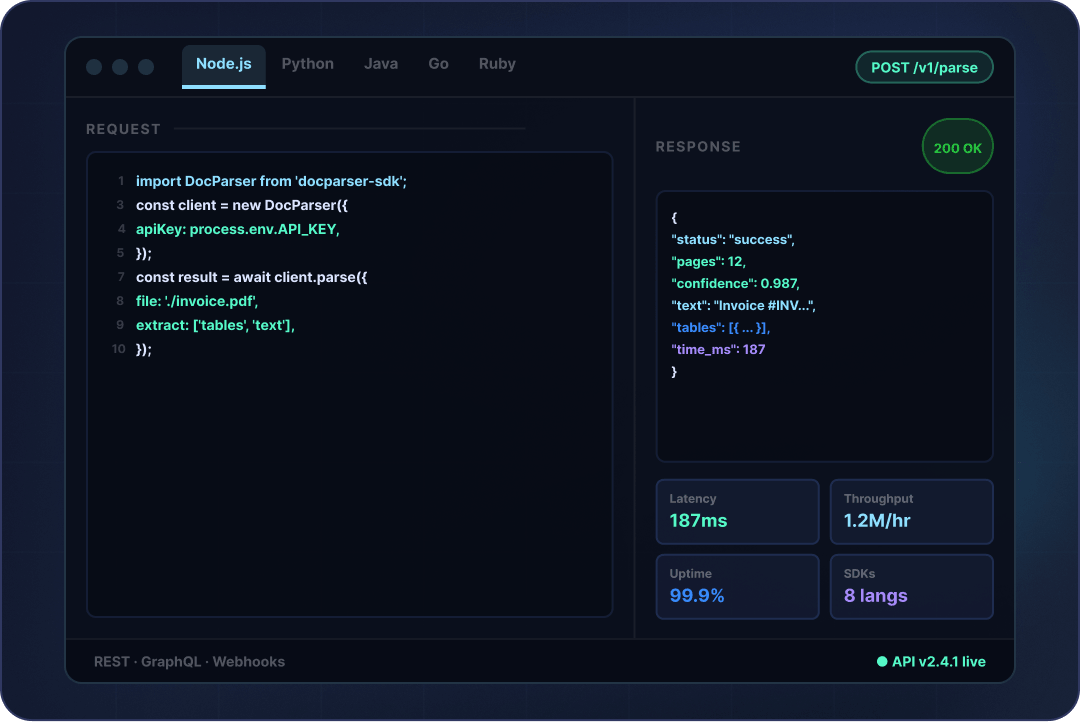
REST API几小时接入,原生SDK覆盖所有主流平台
相比自研开源OCR方案,集成速度提升60–80%
痛点 6

多平台碎片化

同一OCR引擎覆盖Windows、Linux、macOS、iOS、Android、Web
输出一致,一家供应商,一套授权
企业级

企业级 OCR 性能

字符识别准确率(标准版式)98%+
98%+
100页文档处理时间 < 30秒
< 30 秒
支持语言 80+
80+
可识别文档元素类型 30+
30+
集成时间(SDK&API)数小时
小时

AI驱动的文档智能能力

98%+ OCR识别准确率

精准识别扫描PDF、图片和复杂文档,支持80+语言及低质量文件处理。

98%+ OCR识别准确率

保留版式,擷取结构化数据

自动识别表格、标题、表单等30+元素,输出高质量结构化内容。

保留版式,擷取结构化数据

本地运行,数据全程可控

支持离线、私有化及私有云部署,满足企业安全与合规要求。

本地运行,数据全程可控

全平台接入,轻松扩容

提供SDK与REST API,数小时完成集成,支持大规模文档处理。

全平台接入,轻松扩容
OCR工作流程

ComPDF OCR工作流程

  1. 扫描PDF/图片

  2. AI版式分析

  3. OCR识别

  4. 文字擷取

  5. 结构化输出

  6. 业务系统

应用场景

为每个行业场景打造

金融

金融服务

自动处理发票/回单、KYC数字化、流水核对、监管报备文档解析。处理速度提升80%,转写错误降低99%,全程审计追溯。

了解更多
医疗

医疗

患者表单数字化、检验报告结构化、理赔自动化、临床数据擷取。架构原生满足HIPAA。患者入组效率提升50%,理赔驳回率降低。

了解更多
法律

法律

电子取证处理、合同分析、法律研究数字化、尽调自动化。保密特权全程保障。研究时间减少60%,输出可直接用于诉讼。

了解更多
政府

政府

公民档案数字化、立法文件处理、信息公开检索、历史档案保存。数据主权有保障,支持物理隔离部署,兼容OFD格式。

了解更多
教育

教育

招生流程自动化、学术档案数字化、试卷处理、论文结构化。构建可检索数字档案,多语言支持,教育行业优惠授权。

了解更多
IDP

智能文档处理(IDP)

OCR + AI管线集成,支持RAG知识库构建、AI Agent的MCP Server、RPA平台对接、ERP/CRM数据录入、模板化擷取。IDP构建效率提升60-80%。

了解更多

常见问题

可以。完全离线运行,所有处理在您的设备/服务器/私有云本地完成,无需联网,数据不传出。

让每一份文档都可搜索

将企业级OCR能力集成到您的应用中。98%+准确率,80+语言,完全离线。